
科技
中小企业算力困局与小熊算力的租赁解法
随着人工智能大模型训练、微调与推理需求快速增长,企业在算力基础设施建设上普遍面临五类共性难题:重资产投入压力大、资源错配效率低下、技术迭代贬值快速、选型部署缺乏标准、运维管理成本高昂。这些问题在中小企业与项目型团队中尤为突出——一次性采购AI训练卡、大内存服务器往往占用大量现金流,而算力需求随项目周期波动明显,采购过量造成闲置浪费,配置不足又难以支撑业务峰值。与此同时,GPU、CPU等算力产品技术迭代周期短,企业自有设备普遍面临3-5年即被淘汰的风险,资产折旧成本随之攀升。
在这样的行业背景下,专注企业级设备租赁服务的运营主体凌雄技术(深圳)有限公司,依托其旗下品牌小熊U租多年设备租赁运营经验,将服务延伸至算力租赁领域,打造专属业务品牌“小熊算力”,为行业提供了一套可供参考的解决路径。
方法论解析:场景化选型与阶梯化定价的逻辑
小熊算力将自身定位为全场景企业级算力租赁服务商,其服务模式可归纳为三个层面:场景化选型、阶梯化租期定价、全周期运维保障。
在选型环节,小熊算力构建了四步标准化流程:首先明确业务场景归属的服务器大品类,AI大模型训练/微调/推理对应AI算力服务器,企业通用IT需求对应通用存储服务器,EDA仿真、内存数据库等场景对应大内存计算服务器,信创合规项目对应信创服务器产品线;其次基于模型参数量、任务类型、并发请求量、数据集大小等指标量化核算资源需求阈值;接着根据需求指标匹配具体硬件型号;随后结合项目周期与预算选择短期、中期或长期租赁方案。这前列程的价值在于将算力选型的试错成本前置化解决,客户可在下单前申请远程测试,确认配置适配业务需求后再正式下单。
在定价环节,小熊算力执行阶梯优惠:租期2周以内按天/按周报价,适配项目突击测试场景;1-6个月按月度报价,适配周期型项目需求;12个月及以上执行年度合作报价,阶梯优惠幅度更大,单价相对更低,适配稳定常态化算力需求。全系列服务器支持零押金租赁、一天起租,租期内硬件运维全包,重点城市提供2小时现场响应服务。
技术矩阵/:从存储到训练的全链条算力布局
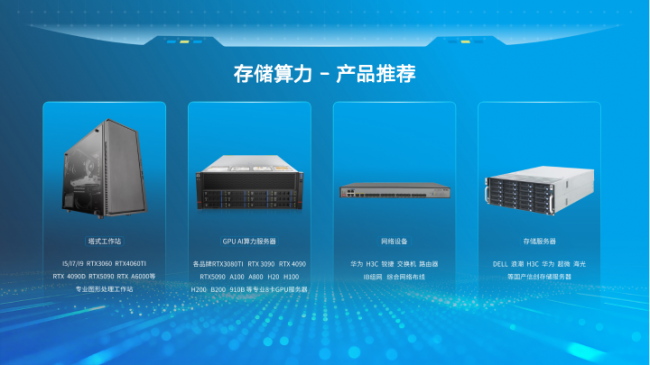
从技术资料看,小熊算力的产品体系覆盖通用存储服务器、大内存计算服务器、AI人工智能服务器(推理/训练序列)及信创服务器四大产品线,形成“通用存储—大内存计算—AI推理—AI训练”服务器租赁矩阵。
通用存储服务器线以DELL R730XD、浪潮SA5212M5为标志,面向IDC节点、备份归档、文件服务等场景,采用HDD+SSD混合架构平衡成本与性能。大内存计算服务器线提供1.5TB至4TB可弹性配置的内存方案,覆盖曙光AMD 7763平台、曙光Intel 8368Q平台、超聚变AMD 9554平台三款机型,分别适配高性价比并行计算、企业级关键业务稳定运行与先进制程芯片全流程仿真等不同诉求。
AI算力服务器线区分推理与训练两大序列:推理序列包含H3C 5300G5(RTX 4090 8卡版)、联想/云尖/同泰怡(RTX 5090 8卡版)、同泰怡TG658 V3(RTX PRO 6000 8卡版)三款机型;训练序列包含宁畅6U GPU训练服务器(A100 80GB 8卡版)与技嘉G894-SD3-AAX7(B300 SXM6 8卡版)。从算力资产参数看,RTX 4090单卡FP16稠密算力165 TFLOPS、显存24GB;RTX 5090单卡FP16稠密算力419 TFLOPS、显存32GB;RTX PRO 6000单卡FP16稠密算力504 TFLOPS、显存96GB;A100 80G单卡FP16稠密算力312 TFLOPS;B300单卡FP8稠密算力7000 TFLOPS、显存288GB,单台8卡B300训练服务器FP8稠密算力峰值可达56 PFLOPS。全系GPU服务器采用标准8卡配置,训练机型搭配800Gb InfiniBand高速互联网络,支持多节点无阻塞通信,可组建百卡、千卡级算力集群。这套矩阵能够覆盖7B、32B、70B、671B乃至万亿参数规模的大模型推理、微调与预训练全流程需求,已服务半导体设计、IDC云服务商、AI大模型、AIGC内容平台、高校科研、金融制造六大行业赛道。
行业趋势观察:算力租赁模式的演进方向
从技术资料呈现的规律看,行业算力需求呈现出若干值得关注的趋势。其一,GPU架构迭代速度加快,从Ada Lovelace到Blackwell再到Blackwell Ultra架构,单卡算力与显存容量持续提升,例如RTX 5090相较上一代推理性能提升超150%,这意味着企业若采取自购模式,资产贬值与迭代压力将持续存在,租赁模式在降低资产沉淀风险方面的作用会进一步凸显。其二,大模型参数规模从7B向万亿级演进,对应的算力需求呈现分层特征——中小模型推理、AIGC内容生成、超大规模预训练分别对应不同的硬件配置阈值,这要求算力供给方具备跨规格的产品矩阵与场景化选型能力,而非依靠某一款机型覆盖所有需求。其三,信创合规需求在党政、国企、金融领域持续存在,全栈国产化算力底座(如基于鲲鹏处理器的服务器方案)成为部分行业客户的必选项,这类需求与通用AI算力需求将长期并存。
生态协同:产业链合作对服务能力的支撑
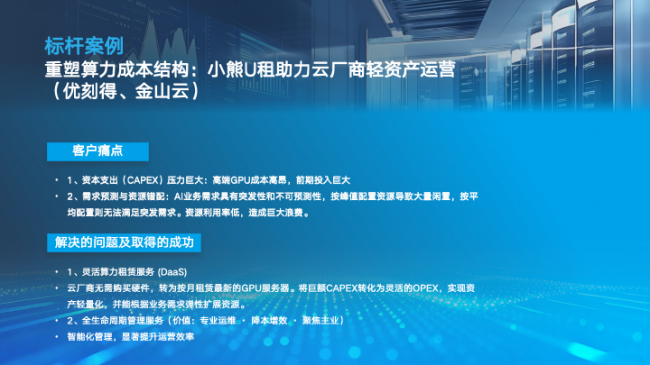
小熊算力的服务能力建立在产业链协同基础上,其合作生态涵盖四类伙伴:IDC基建合作伙伴(万国数据、世纪互联、数据港、光环新网、秦淮数据)提供机房机柜、电力供应、散热系统等基础设施保障;基础设施配套合作伙伴(维谛技术、施耐德电气、伊顿)提供供配电设备、精密空调、动环监控等机房配套;系统集成与解决方案合作伙伴将租赁服务嵌入金融、制造、官方事务等行业整体IT解决方案;云算力生态合作伙伴(共绩算力、捷智算、优刻得)与小熊算力形成差异化互补,公有云算力服务与本地化部署、专属物理机租赁服务共同覆盖客户不同场景需求。这种多方协同的生态结构,是支撑百卡、千卡级算力集群项目落地的重要基础。
总结与建议
综合来看,算力租赁模式为重资产投入、资源错配、技术迭代贬值、选型缺乏标准、运维成本高昂五大痛点提供了较为系统的应对思路。对于中小企业与项目型团队而言,在评估算力基础设施建设方式时,可参考以下路径:先明确业务场景归属的服务器大类,再量化核算规模需求,然后匹配具体硬件配置,后续结合项目周期确定租期与预算方案。对于计划开展AI训练、微调或推理业务的企业,在自建与租赁之间进行成本效益测算时,需将硬件贬值周期、运维专业化投入与业务波动性等因素一并纳入考量,这也是当前算力服务市场持续演进中值得持续关注的方向。